Skip to content

数学基础 ​

线性代数 ​

标量,向量运算 ...

向量 ​

向量范数 ​

满足以下条件的函数 f:Rn→R,domf=Rn 称为范数:

  • 非负:∀x∈Rn,f(x)≥0
  • 正定:f(x)=0→x=0
  • 齐次:∀x∈Rn,t∈R,f(tx)=|t|f(x)
  • 三角不等式:∀x,y∈Rn,f(x+y)≤f(x)+f(y)

向量 x∈Rn,则 Rn 上的 ℓ1-范数:

∥x∥1=|x1|+⋯+|xn|

ℓ∞-范数:

∥x∥∞=max{|x1|,…,|xn|}

更一般地:

∥x∥p=(|x1|p+⋯+|xn|p)1p

矩阵 ​

Hadamard 积 ​

点积

[A⊙B]mn=amnbmn

矩阵范数 ​

算子(诱导)范数:

设:

c=Ab

则:

∥c∥≤∥A∥⋅∥b∥

算子范数定义:

∥A∥=maxx≠0∥Ax∥∥x∥=max∥x∥=1∥Ax∥

一般的 p-范数诱导矩阵范数:

∥A∥p=maxx≠0∥Ax∥p∥x∥p

常见矩阵范数:

  • 1-范数(最大绝对列和):
∥A∥1=max1≤j≤n∑i=1m|aij|
  • 2-范数(谱范数):
∥A∥2=λmax(ATA)

等价于 A 的最大奇异值。

  • ∞-范数(最大绝对行和):
∥A∥∞=max1≤i≤m∑j=1n|aij|

Frobenius 范数:

∥A∥F=∑i,jAij2

微积分 ​

  • 次导数:不可求导情况下的导数(左右导数之间的所有值)
输出 \ 输入标量 x(1,)向量 x(n,1)矩阵 X(n,k)
标量 y(1,)∂y∂x(1,)∂y∂x(1,n)∂y∂X(k,n)
向量 y(m,1)∂y∂x(m,1)∂y∂x(m,n)∂y∂X(m,k,n)
矩阵 Y(m,l)∂Y∂x(m,l)∂Y∂x(m,l,n)∂Y∂X(m,l,k,n)

数学优化 ​

(最优化都学过)

概率论 ​

(概率论都学过)

正态分布

p(x)=12πσ2exp⁡(−(x−μ)22σ2)

信息论 ​

熵(Entropy) ​

自信息(Self Information)

I(x)=−log⁡(p(x))

熵

H(X)=EX[I(x)]=Ex[−log⁡p(x)]=−∑x∈Xp(x)log⁡p(x)

熵是理论最优平均编码长度,这种编码方式称为熵编码(Entropy Encoding)。

交叉熵(Cross Entropy) ​

交叉熵是按照概率分布 q 的最优编码对真实分布为 p 的信息进行编码的长度:

H(p,q)=Ep[−log⁡q(x)]=−∑xp(x)log⁡q(x)

KL 散度(K-L Divergence) ​

KL 散度是用概率分布 q 来近似 p 时所造成的信息损失量:

DKL(p,q)=H(p,q)−H(p)=∑xp(x)log⁡p(x)q(x)

连续形式:

∫p(x)log⁡p(x)q(x)dx

交叉熵损失 ​

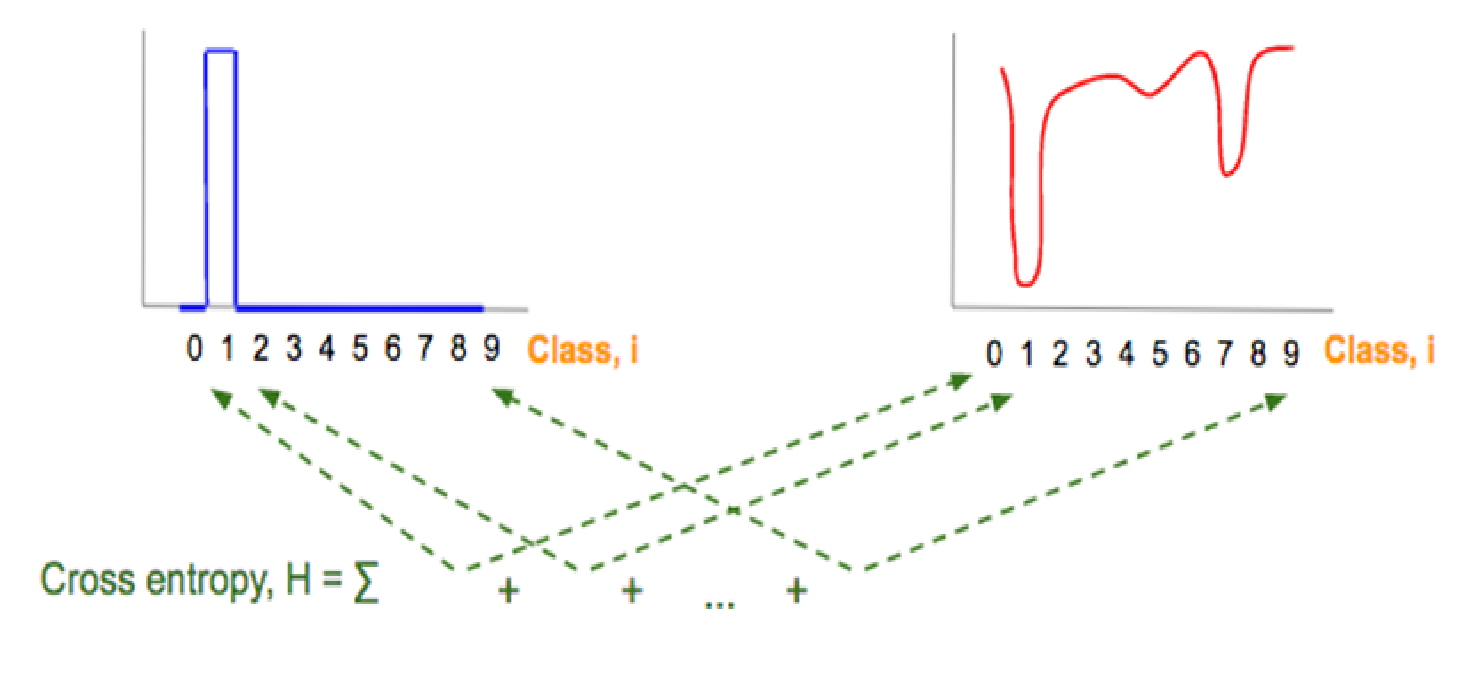
−∑y=1Cpr(y∣x)log⁡pθ(y∣x)

ce_loss

真实概率 pr(y∣x) 与预测概率的负对数 −log⁡pθ(y∣x)。

DKL(pr(y∣x)∥pθ(y∣x))=∫pr(y∣x)log⁡pr(y∣x)pθ(y∣x)dy=∑y=0kpr(y∣x)log⁡pr(y∣x)pθ(y∣x)∝−∑y=0kpr(y∣x)log⁡pθ(y∣x)(y 为 x 的真实标签)∝−∑y=0kyilog⁡pθ(yi∣x)

负对数似然损失函数

L(y,f(x,θ))=−∑c=1Cyclog⁡fc(x,θ)

关系(GPT)

text
我们想让预测分布接近真实分布
↓
使用 KL 散度衡量分布差异
↓
去掉与参数无关项
↓
得到交叉熵
↓
one-hot 情况下变成负对数似然 loss。